
Mike Nason PRO
Open Scholarship and Publishing Librarian @ UNB Libraries // Metadata Nag and DOI Wrangler @ PKP // General Loudmouth and Malcontent
Un webinaire du Public Knowledge Project
Mike Nason | Bibliothécaire spécialisé en science ouverte et édition @ Bibliothèques de l'UNB
Conseiller en infrastructure scientifique ouverte @ Public Knowledge Project (PKP)
Müge Bakioğlu | Spécialiste du soutien à la publication, PKP
Le PKP est une installation de recherche et de développement logiciel à l'Université Simon Fraser.
Depuis 1998, la mission du PKP est de rechercher, développer et soutenir une infrastructure ouverte pour accroître la qualité, la diversité et la portée de l'édition scientifique.
Le Public Knowledge Project développe des logiciels open source utilisés dans le monde entier pour la publication de revues, de prépublications et de monographies dirigée par des chercheurs et axée sur la communauté.
Un système permettant aux auteurs de soumettre leurs travaux à une revue scientifique, de suivre leur soumission tout au long du processus éditorial, de télécharger des révisions et de publier, souvent en libre accès.
Un système permettant aux éditeurs de gérer les soumissions à différentes étapes, de suivre les versions des manuscrits et de gérer les communications entre les auteurs, les éditeurs et les évaluateurs.
Un système permettant aux évaluateurs d'accepter ou de refuser des demandes d'évaluation par les pairs, de consulter les soumissions, de communiquer avec les éditeurs et de soumettre des rapports d'évaluation.
Un site web de publication personnalisable et multilingue avec des outils intégrés d'indexation, de diffusion et de préservation.
Le logiciel du PKP est développé, maintenu et soutenu par une communauté mondiale de développeurs, d'utilisateurs, de traducteurs, de contributeurs financiers et de partenaires stratégiques.
Le PKP fournit des ressources pour aider les utilisateurs de nos logiciels à développer leurs connaissances et à améliorer leurs pratiques d'édition scientifique.
Le PKP construit et maintient également PKP School, un ensemble de cours en ligne, ouverts et à rythme libre, conçus pour aider les utilisateurs à comprendre comment utiliser le logiciel, à participer à l'édition scientifique et à améliorer la qualité de l'édition scientifique dans le monde entier.
Nous allons parler de la version d'OJS que votre revue devrait utiliser, de l'importance de ce choix, et de certaines raisons pour lesquelles vous devriez envisager de passer rapidement à la dernière version « à long terme » du logiciel, OJS 3.5.
La qualité de vos métadonnées est tellement importante pour l'indexation, la découvrabilité et le succès de votre revue. Nous allons parler des ressources pour les meilleures pratiques, de la façon de trouver/corriger les métadonnées dans votre revue, et discuter du parcours de vos métadonnées lorsque vous cliquez sur le bouton « publier » dans OJS.
Ce qu'est l'infrastructure scientifique ouverte et pourquoi il est important pour les revues d'y être connectées.
Nous parlerons également de l'endroit où trouver les paramètres, remplir les politiques et de la meilleure façon de préparer votre revue au succès.
Dès son installation, Open Journal Systems soutient énormément l'infrastructure scientifique ouverte. En fait, OJS est un exemple d'infrastructure scientifique ouverte, dont nous parlerons ici dans une minute.
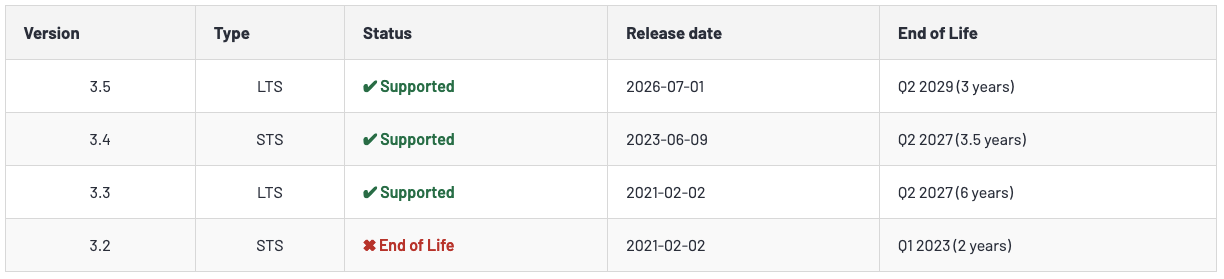
Le webinaire d'aujourd'hui utilisera une version plus récente d'OJS. Si vous exploitez des identifiants persistants (PID) et d'autres connexions à l'infrastructure ouverte, il est probablement préférable de rester à jour, au moins, avec la dernière version à support à long terme (LTS).
PRÉCÉDENTE VERSION LTS
GRANDE BASE D'INSTALLATION
VASTE SÉLECTION DE PLUGINS TIERS
DÉPÔT DE DOI PAR PLUGIN
SERA SIGNALÉE POUR FIN DE VIE DANS L'ANNÉE SUIVANT LA DÉSIGNATION LTS D'OJS 3.5
VERSION LA PLUS RÉCENTE
MEILLEUR SUPPORT DES MÉTADONNÉES
AMÉLIORATION SIGNIFICATIVE DU FLUX DE TRAVAIL DE PUBLICATION
AMÉLIORATIONS SIGNIFICATIVES DE L'INTERFACE UTILISATEUR
A APPORTÉ UN CERTAIN NOMBRE DE CHANGEMENTS AUX STATISTIQUES, À LA GESTION DES UTILISATEURS ET AUX FLUX DE TRAVAIL DE SOUMISSION
PLUS DE FONCTIONNALITÉS ITÉRATIVES
FLUX DE TRAVAIL DE GESTION/DÉPÔT DE DOI REVISITÉS
A APPORTÉ UN CERTAIN NOMBRE DE CHANGEMENTS AUX STATISTIQUES, À LA GESTION DES UTILISATEURS ET AUX FLUX DE TRAVAIL DE SOUMISSION
PLUS DE FONCTIONNALITÉS ITÉRATIVES
FLUX DE TRAVAIL DE GESTION/DÉPÔT DE DOI REVISITÉS
À un minimum absolu, je recommanderais d'exécuter la dernière version d'OJS 3.3 pour vous assurer d'avoir tous les derniers correctifs et mises à jour de sécurité.
Mais, avec la sortie d'OJS 3.5 et son statut mis à jour en tant que nouvelle version LTS d'OJS, vous devriez prévoir de mettre à jour dès que possible.
Rester à jour sur la version LTS est une bonne pratique et aidera à garantir une plateforme stable et sécurisée pour votre revue.
Cela dépend ! Votre expérience avec le logiciel sera différente selon la version que vous avez installée. Souvent, le compromis pour les versions plus récentes d'une plateforme est que vous obtenez les meilleures et les plus récentes fonctionnalités, mais vous devez également appliquer des mises à jour plus fréquentes pour garder les choses sécurisées et sans bogues.
Cependant, si vous utilisez actuellement une version d'OJS 3.2 ou plus ancienne, c'est très important. Vous devriez absolument, au moins, mettre à niveau vers la dernière version d'OJS 3.3, et, mieux encore, OJS 3.5.
OJS 3.2 n'est plus pris en charge et vous manquerez les mises à jour de sécurité et les corrections de bogues.
Si vous êtes sur la version 3.3 et que vous êtes satisfait de la situation, vous devriez tout de même envisager de passer à OJS 3.5.
OJS 3.3 ne recevra plus de support, de mises à jour de sécurité ou de correctifs après le deuxième trimestre 2027*.
J'aimerais commencer par un exemple qui, je pense, aidera à fonder notre compréhension.
Nous commencerons par parler du DOI.
Il est un peu difficile de parler d'infrastructure scientifique ouverte au sens large.
Un bâtiment gouvernemental, un réseau électrique, un système éducatif ou un réseau routier sont tous des exemples traditionnels de ce que nous appelons des « infrastructures ». Mais ils sont chacun uniques.
Les DOI sont omniprésents. Nous les voyons partout :
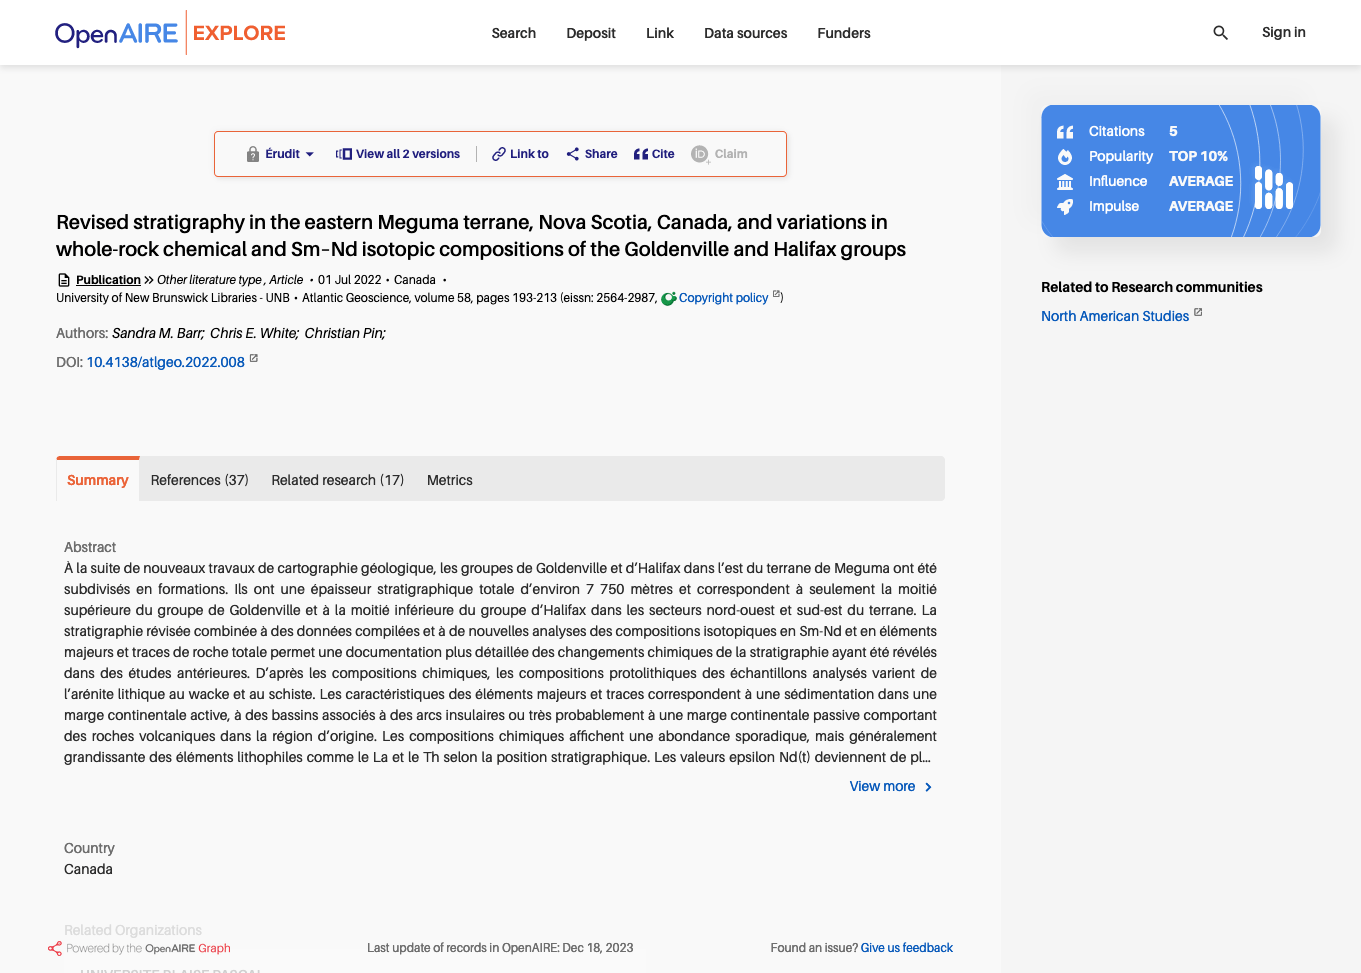
Barr, S. M., White, C. E., & Pin, C. (2022). Revised stratigraphy in the eastern Meguma terrane, Nova Scotia, Canada, and variations in whole-rock chemical and Sm–Nd isotopic compositions of the Goldenville and Halifax groups. Atlantic Geoscience, 58, 193–213. https://doi.org/10.4138/atlgeo.2022.008
Et nous connaissons probablement une chose pratique à leur sujet :
Si vous cliquez sur un DOI qui ressemble à un lien, il vous mènera à la chose.
Les DOI sont l'identifiant persistant le plus important.
Ils sont aussi, sans doute, l'identifiant persistant le plus essentiel.
Un DOI est composé de deux parties : un préfixe et un suffixe.
préfixe
10.4324
suffixe
9780203051238-5
Ensemble, ils forment le DOI 10.4324/9780203051238-5
Les préfixes et les suffixes signifient des choses différentes.
préfixe
10.4324
Un préfixe est généralement associé à un éditeur ou à une organisation. Les DOI de cette organisation auront généralement le même préfixe.
suffixe
9780203051238-5
Un suffixe est censé être une chaîne opaque, unique et lisible par une machine (pas par un humain), spécifique à l'œuvre unique à laquelle il est attribué.
préfixe
10.4138
Ce préfixe est détenu par le membre de Crossref, Atlantic Geoscience, une revue que nous hébergeons dans mon institution d'origine.
suffixe
atlgeol.2022.008
Vous pouvez voir ici que leurs suffixes suivent un modèle, et vous pouvez probablement deviner ce modèle. C'est très courant, bien qu'à la fois inutile et découragé.
Si je fais précéder un DOI par https://doi.org/, il se transforme en URL.
https://doi.org/10.4138/atlgeol.2022.008
Cliquer dessus me redirigera vers la publication associée à ce DOI.
> Le processus par lequel un DOI vous redirige vers une publication est appelé résolution.
Les DOI ne sont pas simplement comme un lien bit.ly ou tiny.url. Si vous n'êtes pas familier avec ces services, ils remplacent un lien très long et encombrant afin que vous puissiez partager quelque chose qui n'est pas énorme.
Par exemple : https://bit.ly/48fy2pZ
Ceci 👆 est un lien bit.ly pour cette présentation.
L'URL réelle pour cette présentation est : https://slides.com/ahemnason/pids-ojs/
bit.ly et tiny.url sont tous deux des redirections de base.
Mais beaucoup de gens traitent les DOI de cette façon, ou supposent que c'est leur seule fonction réelle.
Ou bien, ils font une sorte d'hypothèse audacieuse selon laquelle les DOI sont une sorte de certification ou une autre preuve que la recherche/les éditeurs sont dignes de confiance.
Un DOI, cependant, est bien plus qu'une redirection. Un DOI est une référence à un dossier de publication complet. Ce dossier de publication est rempli de métadonnées.
Et l'un de ces éléments de métadonnées est l'URL de la publication.
Lorsque vous résolvez un DOI en cliquant dessus :
L'URL peut être mise à jour par l'éditeur. Le DOI reste le même.
<?xml version="1.0" encoding="UTF-8"?>
<crossref_result version="3.0" xsi:schemaLocation="http://www.crossref.org/qrschema/3.0 http://www.crossref.org/schemas/crossref_query_output3.0.xsd">
  <query_result>
    <head>
      <doi_batch_id>none</doi_batch_id>
    </head>
    <body>
      <query status="resolved">
        <doi type="book_content">10.4324/9780203051238-5</doi>
        <crm-item name="publisher-name" type="string">Informa UK Limited</crm-item>
        <crm-item name="prefix-name" type="string">Informa UK (Routledge)</crm-item>
        <crm-item name="member-id" type="number">301</crm-item>
        <crm-item name="citation-id" type="number">122425695</crm-item>
        <crm-item name="book-id" type="number">1477192</crm-item>
        <crm-item name="deposit-timestamp" type="number">2020122110554080199</crm-item>
        <crm-item name="owner-prefix" type="string">10.4324</crm-item>
        <crm-item name="last-update" type="date">2020-12-21T15:07:00Z</crm-item>
        <crm-item name="created" type="date">2020-12-21T15:06:59Z</crm-item>
        <crm-item name="citedby-count" type="number">0</crm-item>
        <doi_record>
          <crossref xsi:schemaLocation="http://www.crossref.org/xschema/1.1 http://doi.crossref.org/schemas/unixref1.1.xsd">
            <book book_type="other">
              <book_metadata language="en">
                <contributors>
                  <person_name sequence="first" contributor_role="author">
                    <given_name>Richard</given_name>
                    <surname>Smiraglia</surname>
                  </person_name>
                </contributors>
                <titles>
                  <title>Metadata</title>
                  <subtitle>A Cataloger's Primer</subtitle>
                </titles>
                <edition_number>0</edition_number>
                <publication_date media_type="online">
                  <month>11</month>
                  <day>12</day>
                  <year>2012</year>
                </publication_date>
                <isbn media_type="electronic">9780203051238</isbn>
                <publisher>
                  <publisher_name>Routledge</publisher_name>
                </publisher>
                <doi_data>
                  <doi>10.4324/9780203051238</doi>
                  <timestamp>2020122110554078499</timestamp>
                  <resource>https://www.taylorfrancis.com/books/9781136435843</resource>
                </doi_data>
              </book_metadata>
              <content_item component_type="chapter" publication_type="full_text" language="en">
                <titles>
                  <title>Understanding Metadata and Metadata Schemes</title>
                </titles>
                <publication_date>
                  <year>2012</year>
                  <month>11</month>
                  <day>12</day>
                </publication_date>
                <pages>
                  <first_page>25</first_page>
                  <last_page>44</last_page>
                </pages>
                <doi_data>
                  <doi>10.4324/9780203051238-5</doi>
                  <timestamp>2020122110554080199</timestamp>
                  <resource>https://www.taylorfrancis.com/books/9781136435843/chapters/10.4324/9780203051238-5</resource>
                </doi_data>
              </content_item>
            </book>
          </crossref>
        </doi_record>
      </query>
    </body>
  </query_result>
</crossref_result>
Je suis désolé de vous faire subir cela.
Il y a beaucoup d'informations ici :
éditeur
horodatage de dépôt et de mise à jour
type de livre
contributeurs (premier, rôle=auteur)
titre et sous-titre
date de publication
doi pour le livre
lien pour le livre
titre du chapitre
doi pour le chapitre
lien pour le chapitre
<doi_data>
  <doi>10.4324/9780203051238</doi>
  <timestamp>2020122110554078499</timestamp>
  <resource>https://www.taylorfrancis.com/books/9781136435843</resource>
</doi_data>
</book_metadata>
<content_item component_type="chapter" publication_type="full_text" language="en">
  <titles>
    <title>Understanding Metadata and Metadata Schemes</title>
  </titles>
  <publication_date>
    <year>2012</year>
    <month>11</month>
    <day>12</day>
  </publication_date>
  <pages>
    <first_page>25</first_page>
    <last_page>44</last_page>
  </pages>
  <doi_data>
    <doi>10.4324/9780203051238-5</doi>
    <timestamp>2020122110554080199</timestamp>
    <resource>https://www.taylorfrancis.com/books/9781136435843/chapters/10.4324/9780203051238-5</resource>
  </doi_data>


<!-- urls are part of the metadata of a doi. -->
<!-- when you change the location of content, you update your doi with the new location. everyone who uses the doi gets to the content no matter where you put it, so long as that doi is updated. this means, the doi is persistent.-->
Félicitations, vous en savez maintenant plus sur les DOI qu'un nombre franchement surprenant de personnes.
Et, par extension, vous avez maintenant été exposé au concept d'infrastructure scientifique ouverte.
Un identifiant persistant ne peut pas fonctionner sans un service ou une agence pour faciliter l'enregistrement, le stockage des données et la récupération de toutes ces informations.
Un tiers est requis. Infrastructure.
C'est pourquoi nous avons des agences d'enregistrement de PID.
Les DOI sont un exemple de ce que nous appelons des « identifiants persistants » (PID).
Les PID sont des identifiants uniques et immuables représentant des objets (numériques ou autres) qui peuvent diriger un utilisateur, sans ambiguïté, vers l'emplacement ou le statut actuel de cet objet, et fournir des informations/métadonnées supplémentaires.
Ils existent pour toutes sortes de choses ! Publications, personnes, immatriculations de voitures...
Les agences d'enregistrement (généralement des organisations internationales à but non lucratif) stockent des enregistrements/métadonnées, facilitent les demandes de résolution et peuvent ou non offrir d'autres services basés sur l'adhésion.
Il existe de nombreuses agences d'enregistrement !
Chacune de ces organisations est un exemple d'infrastructure scientifique ouverte.
Les agences d'enregistrement fournissent des schémas de métadonnées grâce auxquels les utilisateurs peuvent décrire les objets pour lesquels ils enregistrent des PID.
Comme vous pouvez l'imaginer, vous décririez une personne différemment de la façon dont vous décririez un jeu de données, un article de revue ou une organisation. Même lorsque les agences utilisent le même type de PID (comme le DOI), le schéma qu'elles utilisent peut varier.
Et ces métadonnées sont utilisées par toutes sortes d'autres acteurs en aval de votre publication. Des choses comme :
Contrairement aux publications elles-mêmes, les métadonnées sont généralement gratuites. Et nous pouvons en apprendre beaucoup. Crossref, par exemple, peut stocker les éléments suivants en tant que métadonnées accessibles au public :
titre
sous-titre
auteurs
orcids
affiliation
licence de droit d'auteur
ids de bailleur de fonds/subvention
langues
ror
références
emplacement de la ressource
version
éditeur
revue
volume/numéro
doi associés
dates
résumés
Crossref rend ces métadonnées disponibles via une API publique.
...est un réseau de plateformes open source, de fournisseurs de services et d'API axés sur la recherche scientifique qui travaillent de concert pour partager des données, éclairer les relations et rendre la recherche plus découvrable.
OpenAlex est un catalogue gratuit et ouvert du système de recherche scientifique mondial. C'est un outil pour les données de publication larges, mais c'est aussi un outil pour révéler les connexions entre les publications, les institutions, les bailleurs de fonds et les chercheurs.
OpenAIRE est un agrégateur de résultats de recherche qui récolte des enregistrements pour des jeux de données, des présentations, des articles, des actes de conférence et de nombreux autres types de contenu. Il extrait du contenu des revues, des éditeurs, des dépôts et les rend interrogeables avec un nombre quelconque de
Le Directory of Open Access Journals (DOAJ) est une plateforme bien connue et cruciale pour l'indexation et la découverte de revues utilisant le libre accès. Ce n'est pas seulement un endroit pour trouver une revue dans laquelle publier ou pour chercher des documents en libre accès, c'est aussi un outil que les bibliothèques peuvent utiliser dans le développement de leurs collections.
Toutes ces organisations font circuler les métadonnées scientifiques et créent des liens entre elles.
Si vous gérez une revue, vous engager dans l'infrastructure scientifique ouverte améliore considérablement la découvrabilité de votre revue. Cela facilite également la visualisation des liens entre la recherche financée, les résultats et les relations entre les chercheurs et les organisations. C'est vraiment bien !
Crossref
DataCite
DOAJ
OpenAIRE
ROR
ORCID
DOCID
OpenAlex
Même OJS est un exemple d'OSI. En fait, le PKP est un adoptant des principes de l'infrastructure scientifique ouverte.
robots d'indexation (bots, etc.)
google scholar
abonnement et rss
robots d'indexation (bots, etc.)
google scholar
abonnement et rss
DOCID
OpenAlex
OpenAIRE
ORCID
robots d'indexation (bots, etc.)
google scholar
abonnement et rss
DOCID
OpenAlex
OpenAIRE
ORCID
ORCID
ROR
DOAJ
OpenAlex
OpenAIRE
ORCID
Les métadonnées que nous obtenons de ces systèmes, et leur utilité, dépendent énormément de leur qualité.
Nous avons une expression générale dans l'univers des métadonnées : « garbage in, garbage out » (déchets en entrée, déchets en sortie).
Les métadonnées de votre revue sont le point d'origine pour tous les consommateurs en aval de l'infrastructure scientifique ouverte.
Une coquille ici (ou une affiliation manquante, un titre en majuscules, ou des erreurs dans le nom de l'auteur) sera une coquille partout ailleurs dans la chaîne.
Les métadonnées sont un peu la responsabilité de tout le monde. Chercheurs, bibliothécaires, éditeurs, agences d'enregistrement... tout le monde a un intérêt dans des métadonnées précises et utilisables.
Pardonnez-moi d'être présomptueux, mais il existe une attente générale selon laquelle vous voulez que les gens voient les produits de votre travail acharné.
Vous voulez que votre travail soit connu et découvrable ; accessible aux personnes qui pourraient en bénéficier.
Je le penserais (j'espère).
Et vous aimeriez probablement qu'il vous soit attribué, puisque vous avez fait le travail et aussi puisque les implications de sa valeur auront un impact sur votre carrière ou la carrière de vos auteurs.
https://science.gc.ca/site/science/fr/science-ouverte
Publier votre travail en tant qu'universitaire moderne déclenche une énorme machine de Rube Goldberg d'infrastructure d'édition scientifique. Nous parlons de données, d'articles, de prépublications, de présentations, d'actes de conférence et d'innombrables autres choses.
C'est une chose importante tant pour une revue que pour les auteurs.
Les auteurs sauront sur quoi ils ont travaillé, par exemple, mais les personnes (chercheurs, bailleurs de fonds, institutions, employeurs) à la recherche de leur travail pourraient ne pas le savoir.
Tous les chercheurs doivent parler du travail qu'ils ont accompli. Souvent. À plusieurs reprises. Et tous les chercheurs bénéficient d'une attribution claire et sans ambiguïté.
Votre travail finira par se retrouver dans beaucoup d'endroits, souvent sans même que vous en soyez vraiment conscient.
Si vous gérez une revue, vous vous tenez à la buse d'un tuyau d'incendie de métadonnées.
Être trouvé, rester trouvé : Identifiants persistants et leur valeur | Un webinaire du PKP, 2024. (Diapositives, Vidéo)
OJS, DOI et Datacite | Un webinaire pour DataCite et PKP, 2025. (Diapositives, Vidéo)
By Mike Nason
Webinar from the Public Knowledge Project.